KI Datenschutz: Risiken, Rechtslage und Schutzmaßnahmen
KI Datenschutz verständlich erklärt: Risiken bei Sprach- und Textdiensten, Pflichten nach DSGVO und KI-Verordnung und Schutzmaßnahmen, die du prüfen kannst.
76 Prozent der deutschen Unternehmen beschränkten 2024 die Eingabe von Daten in generative KI-Tools, laut der Cisco Data Privacy Benchmark Study 2024, einer Befragung von Datenschutz- und Sicherheitsexperten. Die praktische Frage ist also nicht nur, ob Du KI nutzt, sondern welche Informationen Du ihr für welchen Zweck überlässt.
Beim Diktieren fällt diese Entscheidung mitten im Arbeitsfluss. Du formulierst eine Kundenmail, erwähnst einen Namen und ergänzt spontan einen vertraulichen Hintergrund.
Eine fehlende Aufnahme im Verlauf beantwortet noch nicht, was währenddessen passiert ist. Für belastbaren KI-Datenschutz brauchst Du den vollständigen Weg Deiner Daten: vom Mikrofon über die Verarbeitung bis zur Textausgabe und Löschung.
Inhaltsverzeichnis
- Welche Regeln bei KI-Datenschutz wirklich gelten
- Wo Daten bei Sprach-KI tatsächlich landen
- Technische Schutzmaßnahmen, die du prüfen kannst
- Wann Sprachdaten als biometrisch gelten
- Drei Irrtümer, die bei KI-Datenschutz teuer werden
- So prüfst du ein KI-Tool Schritt für Schritt
Welche Regeln bei KI-Datenschutz wirklich gelten
Sobald eine KI personenbezogene Daten verarbeitet, gilt die DSGVO, und die KI-Verordnung kommt als zusätzliche Regelungsebene dazu. Für die Freigabe eines Tools solltest Du deshalb Datenschutzrecht und KI-Pflichten getrennt prüfen und anschließend zusammenführen.
Regelwerke für KI und personenbezogene Daten
| Regelwerk | Was es regelt | Gilt seit | Bedeutung für Sprach-KI |
|---|---|---|---|
| DSGVO | Verarbeitung personenbezogener Daten, auch Audio und Transkripte | 25. Mai 2018 | Gilt, sobald Personen identifiziert oder identifizierbar sind |
| KI-Verordnung | Risiken, Pflichten und Verbote für KI-Systeme | Inkrafttreten 1. August 2024, KI-Kompetenz und einzelne Verbote ab 2. Februar 2025 | Ergänzt die DSGVO, ersetzt sie nicht |
| TDDDG | Zugriff auf Informationen in Endgeräten und Telekommunikation | Unter dieser Bezeichnung seit Mai 2024 | Ergänzend prüfen, wenn Informationen auf dem Gerät gespeichert oder abgerufen werden |
| Art. 9 DSGVO | Besondere Kategorien, beispielsweise biometrische Daten | 25. Mai 2018 | Bei Biometrie insbesondere relevant, wenn die Stimme zur eindeutigen Identifizierung dient, außerdem bei sensiblen Inhalten |
Den stufenweisen Anwendungsbeginn der KI-Verordnung erläutert der offizielle deutsche Zeitplan des Bundesministeriums für Digitales und Staatsmodernisierung: Inkrafttreten war am 1. August 2024, Vorgaben zur KI-Kompetenz und bestimmte Verbote gelten seit 2. Februar 2025. Für Deine Prüfung ist wichtig, welche Rolle Du übernimmst und wofür Du das System tatsächlich einsetzt.
Datenschutz bei KI ist kein eigener Sonderbereich, sondern die bekannten DSGVO-Pflichten plus neue Risikopflichten.
Entscheidend ist der Inhalt, nicht die Dateiendung
Ein Diktat wie „Bitte verschiebe den Termin von Frau Schneider wegen ihrer Behandlung“ enthält einen Namen und möglicherweise Gesundheitsinformationen. Ob daraus eine Audiodatei entsteht oder das Signal nur vorübergehend verarbeitet wird, ändert nichts an der notwendigen Prüfung.
Die Orientierungshilfe der Datenschutzkonferenz zu KI und Datenschutz macht die allgemeinen Anforderungen an personenbezogene KI-Eingaben deutlich: Zweck, Rechtsgrundlage nach Art. 6 Abs. 1 DSGVO, Empfänger, Speicherfristen und Betroffenenrechte müssen nachvollziehbar sein. Eine Einwilligung ist dabei nicht automatisch die passende oder einzige Rechtsgrundlage.
Die sächsische Datenschutzaufsicht zu künstlicher Intelligenz stellt klar, dass die KI-Verordnung die DSGVO nicht verdrängt. Die BfDI betont außerdem die belastbare Rechtsgrundlage für jede Lebensphase eines KI-Systems und die Bedeutung gespeicherter oder memorisierter Daten.
Prüfe deshalb nicht nur den Kaufvertrag, sondern auch den konkreten Verarbeitungsauftrag. Unsere AGB sind ein Vertragsbaustein, ersetzen aber weder Deine Zweckfestlegung noch einen erforderlichen Auftragsverarbeitungsvertrag.
Wo Daten bei Sprach-KI tatsächlich landen
Laut der TÜV-ChatGPT-Studie 2025 haben 13 Prozent der Menschen in Deutschland bereits persönliche Daten wie Adressen oder Passwörter in KI-Systeme eingegeben. Bei Sprache lässt sich eine sensible Information besonders leicht beiläufig mitgeben.
Der Datenfluss lässt sich als Verarbeitungskette prüfen. Die Auswertung für Trainingszwecke ist dabei eine mögliche zusätzliche Nutzung, kein notwendiger Bestandteil jeder Sprach-KI.
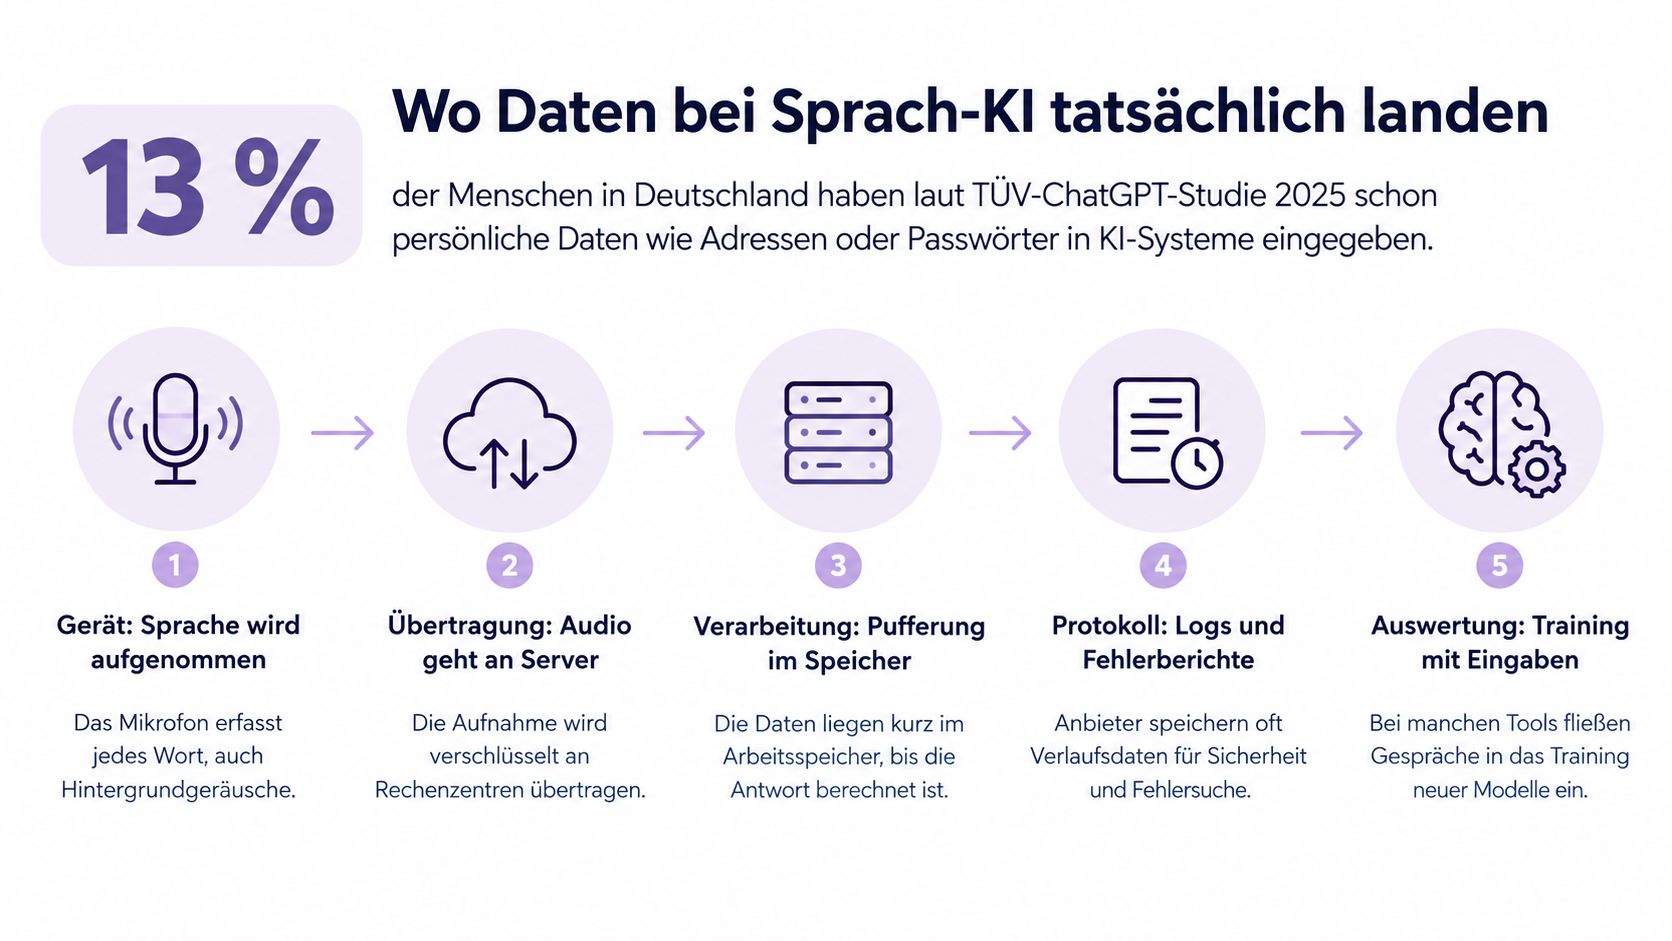
Vom gesprochenen Satz zum fertigen Text
Am Mikrofon beginnt die Kontrolle: Wird nur während Deines bewussten Diktats aufgenommen? Befindet sich jemand im Raum, dessen Stimme unbeabsichtigt mit erfasst werden könnte?
Bei der Übertragung zählt, welche Daten das Gerät verlassen und welcher Dienst sie empfängt. Danach können Zwischenpuffer entstehen, bevor ein Modell das Audiosignal transkribiert und eine weitere Verarbeitung den Text korrigiert.
An der Cursor-Position endet der Weg nicht automatisch. Der fertige Text unterliegt anschließend auch den Speicher-, Freigabe- und Synchronisationsregeln des Zielprogramms, etwa Deiner Mailanwendung oder Kundenverwaltung.
Datenlebenszyklus einer Diktat-Aufnahme
| Stufe | Risiko | Prüffrage |
|---|---|---|
| Mikrofon und Übertragung | Audio verlässt das Gerät | Wird nur die für die Transkription notwendige Aufnahme übertragen? |
| Zwischenpuffer | Audio liegt kurz im Speicher oder auf dem Server | Wann wird der Puffer gelöscht und lässt sich das belegen? |
| Transkription und KI-Korrektur | Inhalte werden verarbeitet | Wird der Inhalt für Modelltraining genutzt? |
| Fehler-Logs | Sprachinhalte landen in Diagnosedaten | Enthalten Logs nur Metadaten wie Zeitstempel und Fehlercode? |
| Textausgabe an der Cursor-Position | Text wird in andere Programme eingefügt | Wird der fertige Text zusätzlich auf dem Server gespeichert? |
| Backups | Kopien bleiben länger als die Verarbeitung | Gibt es eine feste Löschfrist für Backups? |
| Administrationszugriff | Personal kann Daten einsehen | Ist der Zugriff rollenbasiert und protokolliert? |
Die unsichtbaren Kopien mitprüfen
Für die Prüfung würde ich zunächst ein Diktat mit erfundenen Namen verwenden. Lass Dir erklären, welche Komponenten diesen Testinhalt erhalten und ob ein Fehlerfall einen anderen Speicherweg auslöst als eine erfolgreiche Transkription.
Gerade Diagnosefunktionen verdienen Aufmerksamkeit. Eine Fehlermeldung darf technisch hilfreich sein, ohne dafür den vollständigen gesprochenen Satz oder das Transkript zu enthalten.
Dass Unternehmen hier Klärungsbedarf sehen, zeigt die repräsentative Bitkom-Umfrage von 2024 unter 605 Unternehmen mit mindestens 20 Beschäftigten in Deutschland: 68 Prozent sagten, KI stelle den Datenschutz vor neue Herausforderungen. Für Vielschreiber ist die vollständige Prozesssicht hilfreich, weil gesprochene Entwürfe oft mehr Kontext enthalten als eine bewusst gekürzte Texteingabe.
Die europäische Übersicht zu vertrauenswürdiger KI beschreibt den zusätzlichen Rahmen für verantwortliche Nutzung. Auch ein rein interner Einsatz gehört deshalb in Deine organisatorische Prüfung.
Nutze unsere Datenschutzhinweise, um die beschriebenen Verarbeitungsschritte mit Deinem eigenen Einsatz abzugleichen. Notiere offene Punkte konkret: nicht „Ist das sicher?“, sondern „Erhält ein Unterauftragnehmer außerhalb der EU Zugriff auf diesen Verarbeitungsschritt?“.
Technische Schutzmaßnahmen, die du prüfen kannst
Prüfe Schutzmaßnahmen in dieser Reihenfolge: erst Verträge und Zuständigkeiten, dann Datenwege und schließlich das tatsächliche Verhalten. Ein Sicherheitsversprechen hilft Dir erst, wenn Du seinen Umfang und die dazugehörigen Nachweise kennst.
Technische Schutzmaßnahmen und ihr Nachweis
| Maßnahme | Was konkret passieren muss | Woran Du es prüfst |
|---|---|---|
| Auftragsverarbeitungsvertrag | Verarbeitung im Auftrag verbindlich regeln, keine eigene Rechtsgrundlage für Deine Eingabe | Vertrag vor dem Einsatz abschließen |
| EU-Hosting und Unterauftragnehmer | Verarbeitung auf EU-Servern, beteiligte Dienstleister offengelegt | Standort und Unterauftragnehmer-Liste schriftlich einholen |
| Zero Data Retention | Audio und Text werden nach der Transkription sofort gelöscht | Löschprotokoll oder präzise schriftliche Zusage anfordern |
| Kein dauerhaftes Audio-Archiv | Rohaufnahmen bleiben nicht liegen | Speicherdauer je Datenart in der Dokumentation prüfen |
| Kein Training mit Kundeneingaben | Eingaben fließen nicht in die Modellverbesserung | Vertragliche Zusage und Dokumentation prüfen |
| Verschlüsselung | Übertragung und gegebenenfalls Speicherung sind verschlüsselt | Sicherheitsdokumentation prüfen |
| Rollenbasierter Zugriff | Nur berechtigte Personen erhalten erforderliche Zugriffe | Administrationsrollen und Zugriffsprotokolle prüfen |
| Logs nur mit Metadaten | Zeitstempel, Latenz und Fehlercode statt Sprachinhalt | Beispiel-Logeintrag anfordern |
Verträge müssen den technischen Weg abbilden
Ein AVV regelt unter anderem die Weisungsbindung des Auftragsverarbeiters. Er macht eine unzulässige Eingabe aber nicht zulässig und ersetzt nicht Deine Entscheidung, welche Daten Du verarbeiten darfst.
Ordne jedem Dienstleister eine konkrete Aufgabe zu: Transkription, Korrektur, Betrieb oder Support. So erkennst Du, ob eine Standortzusage die gesamte Verarbeitung umfasst oder nur einen Teil.
Die Grundsätze Zweckbindung, Datenminimierung und Transparenz sind auch für KI-Anwendungen maßgeblich, wie die Bundesnetzagentur im Überblick zum europäischen KI-Rahmen einordnet. Praktisch heißt das: Für eine reine Texteingabe brauchst Du kein dauerhaftes Archiv der gesprochenen Rohfassung.
Bei fluesta laufen Transkription und KI-Korrektur ausschließlich auf EU-Servern und nach dem Prinzip Zero Data Retention. Wir speichern kein Audio und stellen Teams einen Auftragsverarbeitungsvertrag auf Anfrage bereit.
Den Normalbetrieb und den Fehlerfall testen
Ein erfolgreicher Testlauf sagt wenig darüber aus, was bei einem Verbindungsabbruch passiert. Prüfe deshalb auch, ob eine abgebrochene Aufnahme lokal liegen bleibt, ein erneuter Versuch zusätzliche Kopien erzeugt oder ein Fehlerbericht Inhalte übernimmt.
• Mit Testdaten starten: Diktiere erfundene Inhalte, keine echten Kunden- oder Beschäftigtendaten.
• Löschumfang abgleichen: Die Zusage sollte Audio, Transkript, Zwischenstände und inhaltsbezogene Diagnoseinformationen ausdrücklich erfassen.
• Nachweise passend wählen: Eine schriftliche Zusage dokumentiert eine Verpflichtung. Ein technischer Nachweis belegt zusätzlich, wie der Prozess umgesetzt wird.
• Bedienung nachvollziehen: Nutze unsere Dokumentation für Installation, Hotkey-Einrichtung und erstes Diktat, damit Dein Praxistest einen klar definierten Ablauf hat.
Prüfregel: Ein Löschprotokoll sollte den Löschvorgang belegen, ohne die gelöschten Sprachinhalte selbst erneut zu speichern.
Weniger gespeicherte Inhalte begrenzen zugleich die Möglichkeiten zur nachträglichen Fehlersuche. Das ist ein sinnvoller Tausch, wenn Support und Diagnose mit technischen Metadaten auskommen und dieser Ablauf sauber dokumentiert ist.
Wann Sprachdaten als biometrisch gelten
Eine reine Transkription bleibt in der Regel eine Verarbeitung personenbezogener Sprachinhalte. Sie wird biometrisch relevant, wenn die Stimme technisch so ausgewertet wird, dass eine Person eindeutig erkannt oder ihre Identität bestätigt werden kann.
Der rechtliche Maßstab ist die besondere technische Verarbeitung körperlicher, physiologischer oder verhaltenstypischer Merkmale zur Identifizierung. Art. 9 Abs. 1 DSGVO verbietet die Verarbeitung biometrischer Daten zur eindeutigen Identifizierung grundsätzlich, sofern keine Ausnahme nach Absatz 2 greift. Prüfe deshalb den Datenlebenszyklus vom Mikrofon bis zur Cursor-Ausgabe: Wird nur der gesprochene Wortlaut übertragen, oder entsteht dabei ein wiedererkennbares Stimmprofil?
Diktat, Sprechertrennung und Identitätsprüfung unterscheiden
• Reines Diktat in eine Textdatei: Das System wandelt Sprache in Text um, ohne daraus die Identität der sprechenden Person zu bestimmen. Das ist in der Regel keine biometrische Identifizierung, kann aber personenbezogene Daten betreffen.
• Sprechertrennung in Besprechungen: Ordnet das System Beiträge nur anonymen Bezeichnungen wie Sprecher A und Sprecher B zu, liegt keine eindeutige Identifizierung vor. Erkennt es dagegen eine bestimmte Person anhand ihrer Stimmmerkmale, ist die biometrische Prüfung erforderlich.
• Stimmprofile über mehrere Aufnahmen: Erkennt ein Tool eine bestimmte Person anhand eines gespeicherten Stimmprofils wieder, liegt eine biometrische Nutzung nahe. Dafür muss zusätzlich zur allgemeinen Rechtsgrundlage eine tragfähige Ausnahme vom Verarbeitungsverbot bestehen.
Die Bezeichnung einer Funktion reicht für diese Einordnung nicht. „Sprechererkennung“ kann eine anonyme Trennung von Stimmen oder die Wiedererkennung namentlich bekannter Personen meinen.
Frage deshalb an jeder Stufe nach Zweck, technischem Verfahren und Identifizierbarkeit. Bleibt die Zuordnung auf die aktuelle Aufnahme beschränkt, steht eher eine Sprechertrennung im Vordergrund. Wird ein personenbezogenes Stimmprofil gespeichert oder über einzelne Aufnahmen hinaus wiedererkannt, geht es um biometrische Nutzung.
Sensible Inhalte sind ein eigener Prüfpunkt
Auch ohne biometrisches Verfahren kann ein Diktat besonders schutzbedürftige Inhalte enthalten. Gesundheitsangaben bleiben eine besondere Kategorie personenbezogener Daten nach Art. 9 DSGVO, auch wenn sie lediglich in Text transkribiert werden.
Bei Mandatsgeheimnissen können zusätzlich berufliche Verschwiegenheitspflichten relevant sein. Eine Aufnahme mit Dritten ist wiederum nicht allein wegen dieser Beteiligung biometrisch, verlangt aber eine eigenständige Prüfung der betroffenen Personen und Inhalte.
Faustregel: Prüfe getrennt, was die Stimme über die Identität verrät und was der gesprochene Inhalt über Menschen offenlegt.
Für den Alltag hilft eine klare Grenze: Reine Entwürfe ohne sensible Angaben lassen sich mit geringerem Prüfaufwand freigeben als Patienteninformationen oder identifizierende Stimmprofile. Sobald ein Tool Stimmen zur Wiedererkennung speichert oder Personen anhand ihrer Stimme identifiziert, kläre die mögliche besondere Datenkategorie vor dem Einsatz mit Deinem Datenschutzbeauftragten.
Drei Irrtümer, die bei KI-Datenschutz teuer werden
Wenn nichts dauerhaft gespeichert wird, ist alles in Ordnung. Diese Annahme übersieht den Zeitraum, in dem das System Deine Eingabe tatsächlich verarbeitet.
Ein Beispiel: Du diktierst eine vertrauliche Personalnotiz, die anschließend aus dem Verlauf verschwindet. Wenn der Inhalt während der Verarbeitung für unnötig viele Administrationskonten erreichbar war, beantwortet der leere Verlauf diese Zugriffsfrage nicht.
Die Abbildung zeigt Datenübertragung als flüchtigen Vorgang. Genau diese Flüchtigkeit ist kein Beleg dafür, dass der Vorgang ohne Datenschutzprüfung auskommt.
Ein europäischer Standort ist der vollständige Nachweis
EU-Hosting ist ein wichtiger Baustein, aber kein vollständiger Datenschutznachweis. Ein Standort sagt für sich genommen nicht, wer Zugriff erhält, welche Zwecke erlaubt sind oder wann Kopien verschwinden.
Die bayerische Datenschutzaufsicht zu KI behandelt deshalb die datenschutzrechtliche Bewertung konkreter Anwendungen, nicht nur die Standortfrage. Für Deine Entscheidung gehören Datenminimierung, Löschkonzept und Rollenverteilung zusammen.
Angenommen, ein Dienst verarbeitet vollständig innerhalb der EU, behält aber alle Entwürfe für eine unbestimmte spätere Analyse. Der europäische Server beantwortet dann nicht, ob diese zusätzliche Nutzung zu Deinem freigegebenen Zweck passt.
Umgekehrt lässt sich eine Standortentscheidung sachlich treffen, ohne pauschal über Anbieter zu urteilen. Du brauchst eine passende Architektur und klare Zusagen für Deinen Einsatz, keine Rangliste vermeintlich sicherer Herkunftsländer.
Zero Data Retention erledigt die DSGVO-Prüfung
Zero Data Retention begrenzt die Datenexposition, ersetzt aber keine zulässige Verarbeitung. Eine sofort gelöschte Eingabe kann trotzdem ohne passende Rechtsgrundlage oder ohne ausreichende Information der Betroffenen verarbeitet worden sein.
Ein leeres Schließfach ohne Quittung beweist wenig. Du kannst daran nicht erkennen, was vorher darin lag, wer es geöffnet hat oder ob der Inhalt zwischenzeitlich kopiert wurde.
Genauso solltest Du eine Löschzusage nicht mit einer vollständigen Freigabe verwechseln. Für das Team müssen erlaubte Inhalte, Verantwortlichkeiten und der Umgang mit Ausnahmen verständlich bleiben.
• Statt einer pauschalen Freigabe: Erlaube einen konkreten Zweck mit klar benannten Datenarten.
• Statt Vertrauen in ein Etikett: Ordne jeder wichtigen Zusage ein Dokument oder einen prüfbaren Prozess zu.
• Statt stiller Einführung: Erkläre Beschäftigten, welche Eingaben zulässig sind und wer offene Fragen entscheidet.
Die sinnvolle Konsequenz ist nicht, auf Diktieren zu verzichten. Welche dieser Annahmen lebt Dein Team bereits, und welche davon lässt sich durch eine konkrete Regel ersetzen?
So prüfst du ein KI-Tool Schritt für Schritt
Beginne mit einem klar begrenzten Einsatz, nicht mit einer allgemeinen Erlaubnis für KI. Ein Diktat für interne Entwürfe braucht eine andere Freigabe als die Verarbeitung von Kundenakten oder Gesundheitsinformationen.
Sind Verträge und technische Unterlagen vorhanden, lässt sich die Prüfung geordnet durchführen. Fehlen Belege, dokumentierst Du die offenen Fragen, statt sie durch Vermutungen zu ersetzen.
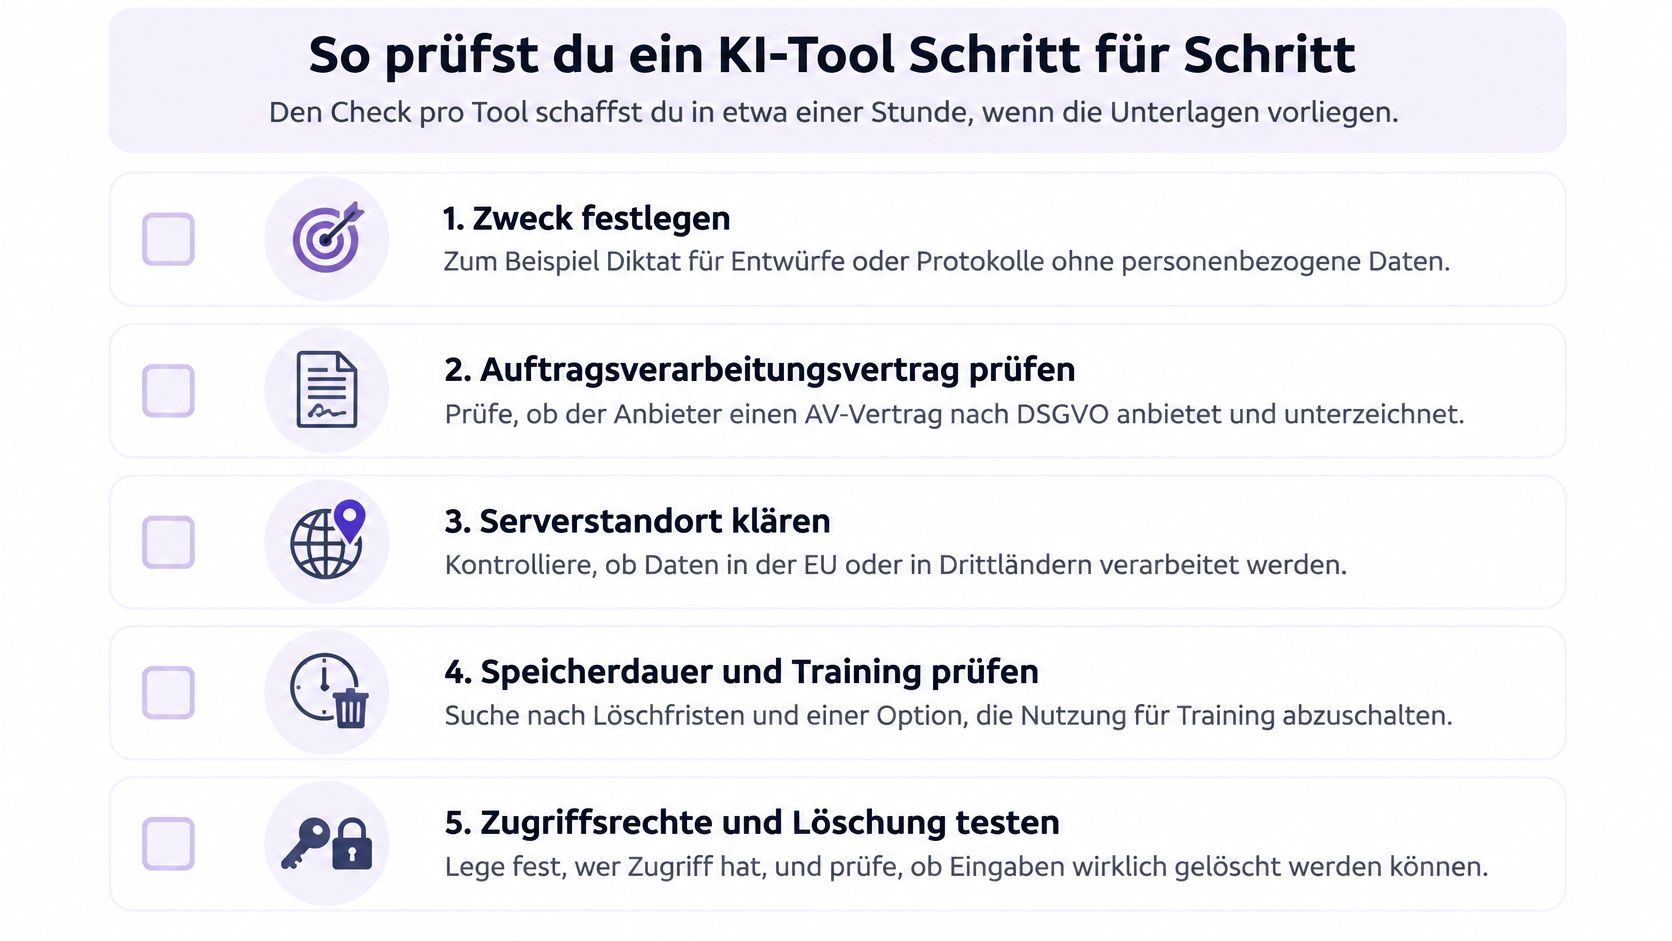
Die Grafik bündelt die wichtigsten Prüffelder. Für eine nachvollziehbare interne Freigabe ergänzen die folgenden Schritte die organisatorischen Details.
Den Einsatz abgrenzen und dokumentieren
Zweck festlegen. Schreibe beispielsweise: Diktat für Textentwürfe ohne Kundenakten. Damit kannst Du zusätzliche Nutzungen erkennen und getrennt bewerten.
Datenarten auflisten. Unterscheide Audio, Transkript, Metadaten und Kontodaten. Ein Löschversprechen für Audio sagt noch nichts über die anderen Kategorien aus.
Ort und Dauer zuordnen. Halte für jede Datenart Verarbeitung, Speicherfrist, Logs und Backups fest. Markiere unklare Angaben ausdrücklich als offen.
Rechtsgrundlage festhalten. Dokumentiere die passende Grundlage nach Art. 6 Abs. 1 DSGVO für Deinen konkreten Zweck. Bei besonderen Kategorien gehört die zusätzliche Zulässigkeitsprüfung dazu.
AVV und Unterauftragnehmer prüfen. Vergleiche Vertragsumfang und tatsächlichen Datenweg. Bei uns erhalten Teams den AVV auf Anfrage, damit sie ihn vor der Freigabe prüfen können.
Verarbeitung verzeichnen. Lege den erforderlichen Eintrag im Verarbeitungsverzeichnis an. Benenne auch intern eine verantwortliche Person für Änderungen und Rückfragen.
Folgenabschätzung bewerten. Prüfe, ob voraussichtlich ein hohes Risiko besteht und deshalb eine Datenschutz-Folgenabschätzung erforderlich ist. Gesundheits- oder Personaldaten sind Anlass für eine genauere Bewertung, nicht automatisch eine fertige Einstufung.
Beschäftigte informieren und Löschweg testen. Erkläre erlaubte Eingaben anhand verständlicher Beispiele. Teste mit erfundenen Daten, damit die Prüfung nicht selbst vertrauliche Inhalte verbreitet.
KI-Kompetenz dokumentieren. Halte fest, welche Nutzer welche Einweisung erhalten haben. Dazu gehören Grenzen der Anwendung, sichere Eingaben und der Umgang mit fehlerhaften Ergebnissen.
Die Freigabe an konkrete Unterlagen knüpfen
Eine Löschung zu behaupten, ohne ihren Umfang belegen zu können, hinterlässt eine unnötige Lücke. Für die Freigabe sollte Deine Unterlagenliste deshalb konkret sein:
• Löschprotokoll oder Löschbestätigung: Mit benannten Datenarten, Zeitpunkt und erfassten Systemkomponenten.
• Unterauftragnehmer-Liste: Mit Aufgabe und Verarbeitungsort der beteiligten Dienstleister.
• Auftragsverarbeitungsvertrag: Passend zu dem Dienst und dem Einsatz, den Du tatsächlich freigibst.
• Trainingsklausel: Mit eindeutigem Ausschluss einer Modellverbesserung durch Deine Eingaben.
Bei fluesta gehören EU-Hosting, Zero Data Retention und keine Unterstellung unter den US Cloud Act zum Datenschutzansatz. Die systemweite Spracheingabe lässt sich dadurch in bestehende Arbeitsabläufe einordnen, ohne daraus eine pauschale rechtliche Freigabe abzuleiten.
Für rechtliche und datenschutzbezogene Anfragen ist legal@fluesta.eu zuständig. Die Entscheidung über Deinen konkreten Einsatz triffst Du mit den zuständigen Verantwortlichen und gegebenenfalls Deinem Datenschutzbeauftragten.
Simon & Furkan aus Berlin entwickeln mit fluesta eine Speech-to-Text Desktop-App für Mac und Windows, die systemweit in jedem Programm funktioniert. Wenn Du weniger tippen und den Datenweg Deiner Sprache nachvollziehbar prüfen möchtest, schau Dir die Anwendung an und nutze die Datenschutzunterlagen für Deine eigene Freigabe.
Related articles
Cloud Datenschutz Vergleich: EU vs USA 2026
Cloud Datenschutz Vergleich 2026: EU Hosting, US Cloud Act, Zero Data Retention und DSGVO Anforderungen für Mittelstand und Compliance Teams.
Prompt engineering deutsch: Bessere Prompts schreiben
Prompt engineering deutsch: Was es ist, welche Bausteine ein starker Prompt braucht, Beispiele vorher und nachher und typische Fehler.
Mausarm vorbeugen: Arbeitsplatz, Pausen und Übungen
Mausarm vorbeugen mit richtiger Mausposition, festen Pausen und einfachen Übungen. Was du heute am Schreibtisch ändern kannst, und wann ein Arzt nötig ist.